Legal Evidence AI
Bez cytatu nie ma twierdzenia: każdy fakt prowadzi do akt.
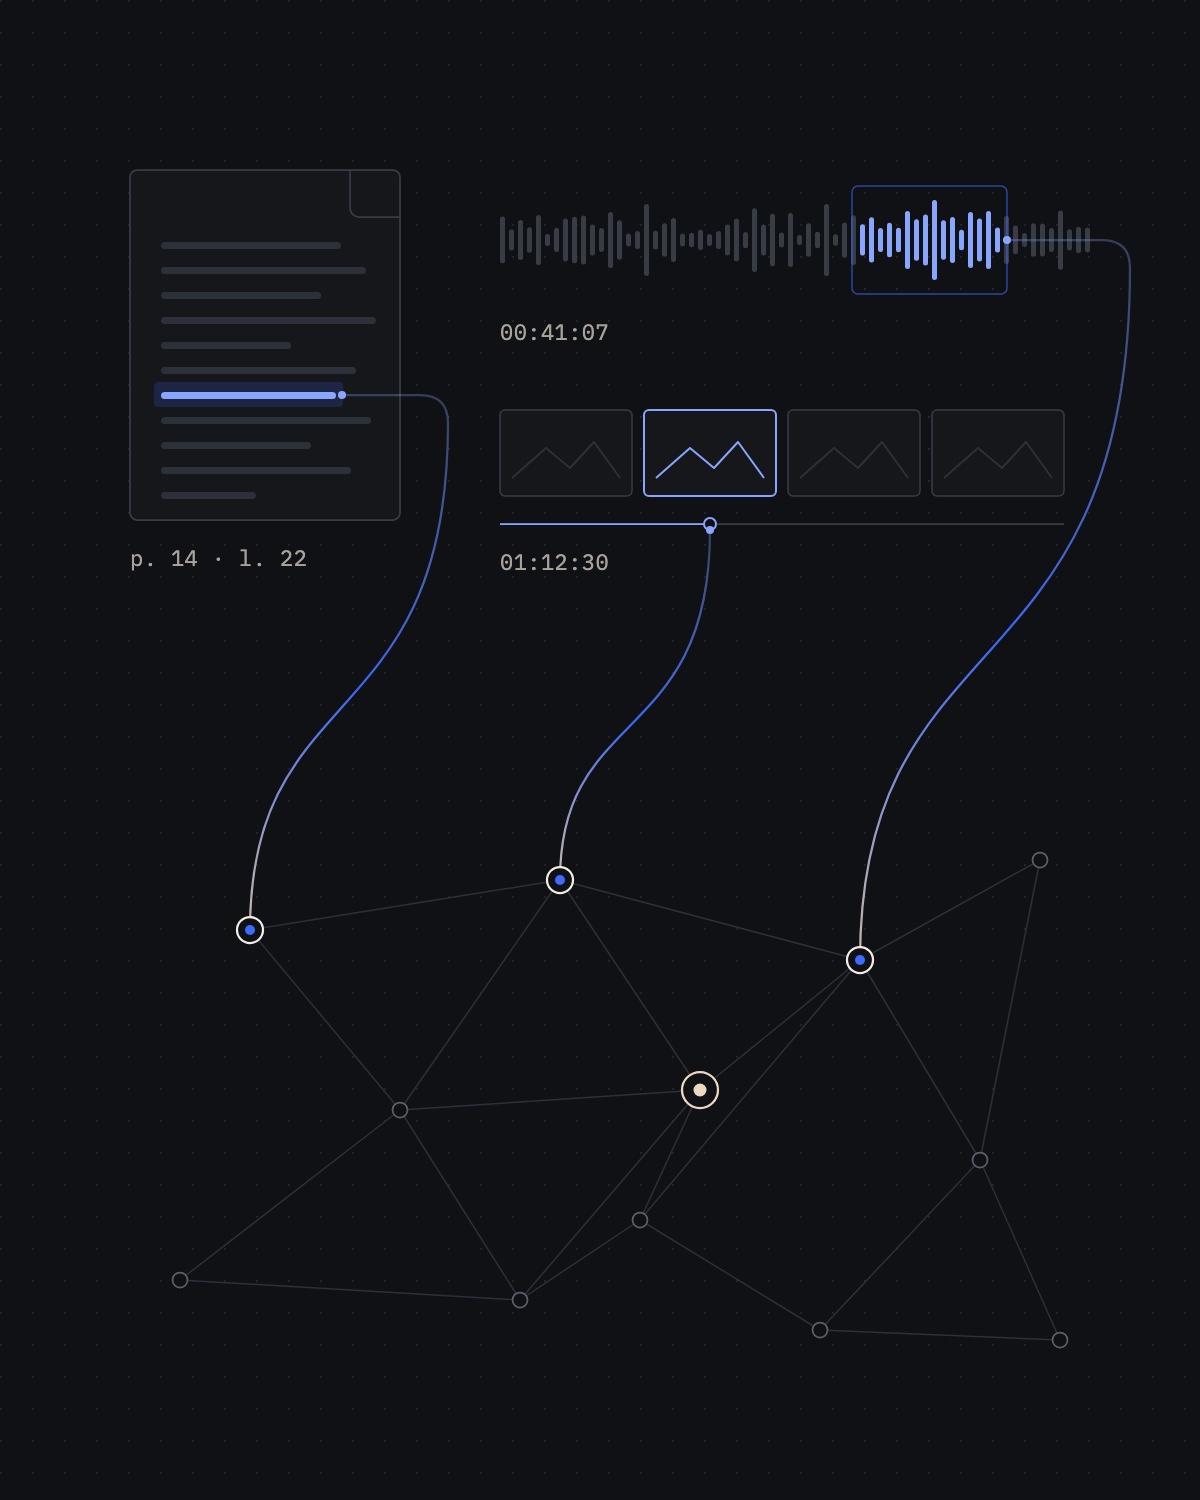
Startup legal-tech, który buduje bazę wiedzy o dowodach dla zespołów procesowych. Czyta całe akta sprawy, dokumenty, nagrania audio i wideo, i odpowiada na pytania faktami, z których każdy wskazuje dokładną stronę, linię lub moment nagrania.
W skrócie
Amerykański startup legal-tech buduje bazę wiedzy dla zespołów procesowych. Prawnik wgrywa całe akta sprawy, od protokołów zeznań i zeskanowanych dowodów po e-maile, eksporty z telefonów i nagrania z kamer nasobnych, i zadaje pytania zwykłym językiem. Każda odpowiedź to krótkie fakty, a każdy z nich wskazuje stronę, linię lub moment nagrania, z którego pochodzi.
Dołączyłem jako główny inżynier w sierpniu 2026 i w pierwszych dwóch miesiącach zbudowałem większość systemu: pipeline przetwarzania, ontologię i graf wiedzy oraz warstwę odpowiedzi na pytania.
Problem i użytkownicy
Akta spraw są duże i chaotyczne: tysiące dokumentów w dziesiątkach formatów i godziny nagrań audio i wideo. Prawnik może użyć tylko faktu, którego obroni, więc każde twierdzenie potrzebuje dokładnego źródła.
Ogólne asystenty AI sobie z tym nie radzą. Ich wyszukiwanie słabnie wraz z rozmiarem akt, odpowiadają długimi akapitami, które trudno sprawdzić, gubią kontekst z innych plików i wypełniają luki prawdopodobnymi domysłami.
Co zbudowaliśmy
Pipeline przetwarzania zamienia każdy plik, od dokumentów i skanów po nagrania audio i wideo, w przeszukiwalny materiał dowodowy, który zachowuje dokładną stronę, linię lub moment nagrania wszystkiego, co znajdzie.
Nad tym działa graf wiedzy z własną ontologią: źródła, encje, fakty, zdarzenia, zagadnienia i relacje między nimi. Maszyna proponuje powiązania, a prawnik je zatwierdza.
Prawnik może wyszukiwać natychmiast albo zadawać pytania zwykłym językiem. Przy pytaniu system sam planuje wyszukiwanie, czyta dokumenty i sprawdza odpowiedź, zanim ją pokaże.
Google Cloud, Python, TypeScript, Knowledge graphs, Ontologies, LLMs
Decyzje techniczne
Ontologia, najtrudniejsza część. To model sprawy sądowej, który maszyna potrafi wypełnić, a prawnik może mu zaufać. Musi opisać każdy rodzaj źródła, od protokołu zeznań po nagranie z kamery nasobnej, śledzić jedną osobę pod wieloma wariantami nazwiska, oddzielać fakty, zdarzenia i zagadnienia, zapisując przy tym, jak się ze sobą wiążą, i pamiętać, kto ustalił każdą wartość: reguła, model czy prawnik. A do tego musi się rozwijać, nie psując tego, co już jest w grafie.
Żadnych zmyślonych faktów. Modele językowe parafrazują cytaty i potrafią przypiąć prawdziwy cytat do błędnego twierdzenia. Każdy cytat i każde zdanie są weryfikowane ze źródłem, zanim zobaczy je prawnik.
Stały koszt przy rosnących sprawach. System jest projektowany pod sprawy liczące setki gigabajtów, a koszt zależy od tego, czego wymaga pytanie, a nie od rozmiaru akt.
Wiele klas modeli AI działających razem: analiza układu dokumentów, OCR, embeddingi i reranking w wyszukiwaniu, rozpoznawanie nazw własnych, rozpoznawanie mowy i rozdzielanie mówców, rozumienie audio i wideo oraz modele językowe, od małych i szybkich po najmocniejsze modele rozumujące.
Dane objęte tajemnicą. Dane każdego klienta są odizolowane, a treść dokumentów nigdy nie trafia do logów.
Decyzje produktowe i biznesowe
Produkt opiera się na trzech zasadach: bez cytatu nie ma twierdzenia; fakty zamiast prozy; AI proponuje, a prawnik decyduje. Gdy akta nie odpowiadają na pytanie, system mówi to wprost, zamiast zgadywać.
Odpowiedzi można zapisać jako aktualizowane chronologie i dossier oraz wyeksportować do Worda.
Efekty i dowody
W około dwa miesiące platforma przeszła od pierwszej linijki kodu do przetwarzania prawdziwych akt z dokumentami, audio i wideo.